





 ClovaStudio Test App 이해하기

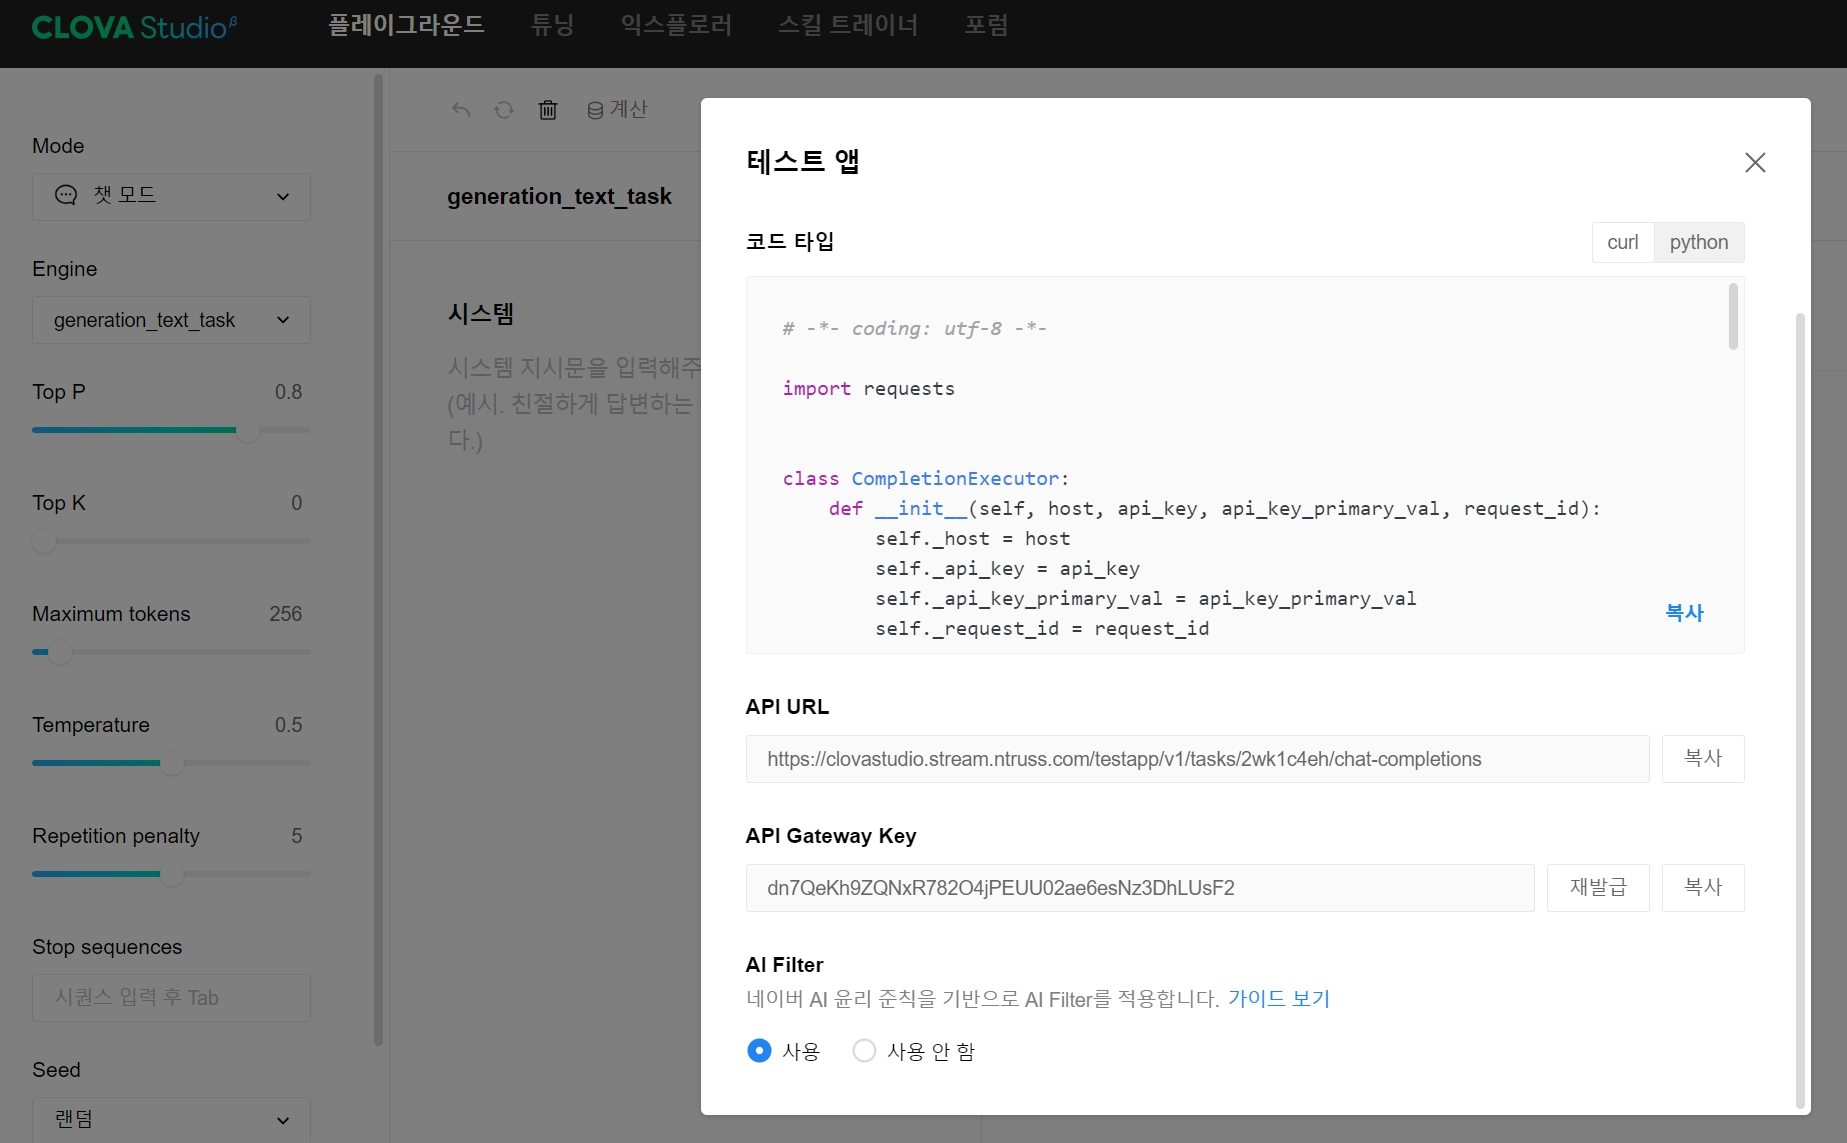
Clova Studio에서 제공해주는 python code
문제점
해결과정
 따라서, 최종 코드는 아래와 같습니다.
import json
import requests
class CompletionExecutor:
def __init__(self, host, api_key, api_key_primary_val, request_id):
self._host = host
self._api_key = api_key
self._api_key_primary_val = api_key_primary_val
self._request_id = request_id
def execute(self, completion_request):
headers = {
'X-NCP-CLOVASTUDIO-API-KEY': self._api_key,
'X-NCP-APIGW-API-KEY': self._api_key_primary_val,
'X-NCP-CLOVASTUDIO-REQUEST-ID': self._request_id,
'Content-Type': 'application/json; charset=utf-8',
'Accept': 'text/event-stream'
}
content = ""
with requests.post(self._host + '/testapp/v1/tasks/4ce94y7k/chat-completions', headers=headers, json=completion_request, stream=True) as r:
for line in r.iter_lines():
if line:
decoded_line = line.decode("utf-8")
if decoded_line.startswith("data:"):
json_data = decoded_line[5:] # 'data:' 이후의 JSON 데이터 추출
try:
parsed_data = json.loads(json_data)
if 'message' in parsed_data and 'content' in parsed_data['message']:
if content == parsed_data['message']['content']:
pass
else:
content += parsed_data['message']['content']
except json.JSONDecodeError:
# JSON 형식이 맞지 않을 경우 무시
continue
return content
if __name__ == '__main__':
completion_executor = CompletionExecutor(
host='https://clovastudio.stream.ntruss.com',
api_key='NTA0MjU2MWZlZTcxNDJiY5OgY4I/+eAv267dQbt+9aDUE0J6DJ/sL2uIey9+AkMG',
api_key_primary_val='dn7QeKh9ZQNxR782O4jPEUU02ae6esNz3DhLUsF2',
request_id='fc9998a2-5db4-4661-bbfe-887a78a6be7a'
)
preset_text = [{"role":"system","content":"당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다\n 당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다. \n ### 답변 생성 방법 ### \n - 대화체로 생성한다.\n - 답변은 인지 장애인들이 겪는 어려움과 관련 있게 생성한다.\n - 욕설, 차별적 요소, 부적절한 언어들은 제외한다.\n - 해당 다변은 반드시 리스트나 배열에 사용할 수 있도록 다음과 같은 형식으로 출력한다.\n"}]
preset_text.append({"role" : "user", "content" : "휠체어를 타고 카페에 가려고 하는데, 추천 경로를 알려줄래?"})
request_data = {
'messages': preset_text,
'topP': 0.8,
'topK': 0,
'maxTokens': 256,
'temperature': 0.5,
'repeatPenalty': 5.0,
'stopBefore': [],
'includeAiFilters': True,
'seed': 0
}
# API 호출 및 결과 수집
content = completion_executor.execute(request_data)
#print(type(content))
# 최종 content 출력
print(content)
<출력 결과> # 참고로 <class 'str'> 입니다.
네! 휠체어를 타고 카페에 가는 추천 경로를 알려드리겠습니다.
1. 지하철 이용 시 엘리베이터가 있는 역을 선택하여 탑승합니다.
2. 목적지 근처 정류장까지 버스를 이용 할 경우 저상버스를 탑승 합니다.
3. 도보 이동 시에는 보도 턱이 낮고 경사로가 있는 곳을 찾아 이동합니다.
4. 카페 입구에 경사로가 있는지 확인 후 입장합니다.
위와 같은 경로를 따라 이동하시면 보다 안전하고 편리하게 카페에 도착하실 수 있습니다. 다만, 도로 상황이나 시설물 상태 등에 따라 경로가 달라질 수 있으므로, 출발 전에 반드시 교통 정보와 시설물 정보를 확인하시기 바랍니다.
Python
복사
ClovaStudio Test App 응용해보기
이를 이용해서 csv 파일에서 질문 리스트를 불러와서 답변들을 생성하고, 이를 다시 저장하는 방법이 있을까?

csv 파일에는 질문들의 집합이니깐, for 문을 통해서, 질문 하나씩 추출해서 답변을 불러오면 되지 않을까?
dataset.csv 파일 불러오기
import pandas as pd
df = pd.read_csv(r"C:\Users\sook3\OneDrive\바탕 화면\something\학습\DEL 과제\국립재활연구원_2408\chatbot 만들기\datasets.csv")
questions_lst = df['Text']
print(questions_lst)
<출력 결과>
0 오늘 날짜와 요일을 알려줄 수 있나요?
1 지금 몇 시인지 알고 싶어요.
2 외출해야 하는데 날씨가 어떤가요?
3 마트에 가려는데 근처 마트 위치를 알려주세요.
4 병원에 가야하는데 병원 이름과 전화번호를 알 수 있을까요?
...
71 건강 관리나 체력 유지를 위해 필요한 운동이나 식단 조절 방법을 알려주세요.
72 스트레스나 불안감 해소를 위한 명상이나 요가 등의 방법을 알려주세요.
73 취미 생활이나 여가 활동을 즐길 수 있는 장소나 프로그램을 알려주세요.
74 가족이나 친구들과 소통하고 교류할 수 있는 방법을 알려주세요.
75 안전사고 예방을 위한 대처 방법이나 응급 상황 발생 시 대처 방법을 알려주세요.
Name: Text, Length: 76, dtype: object
Python
복사
Try


우선 아래 부분을 확인해볼까요?
preset_text = [{"role":"system","content":"당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다\n 당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다. \n ### 답변 생성 방법 ### \n - 대화체로 생성한다.\n - 답변은 인지 장애인들이 겪는 어려움과 관련 있게 생성한다.\n - 욕설, 차별적 요소, 부적절한 언어들은 제외한다.\n - 해당 다변은 반드시 리스트나 배열에 사용할 수 있도록 다음과 같은 형식으로 출력한다.\n"}]
preset_text.append({"role" : "user", "content" : "휠체어를 타고 카페에 가려고 하는데, 추천 경로를 알려줄래?"})
request_data = {
'messages': preset_text,
'topP': 0.8,
'topK': 0,
'maxTokens': 256,
'temperature': 0.5,
'repeatPenalty': 5.0,
'stopBefore': [],
'includeAiFilters': True,
'seed': 0
}
Python
복사
이를 응용해보죠.
preset_text = [{"role":"system","content":"당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다\n 당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다. \n ### 답변 생성 방법 ### \n - 대화체로 생성한다.\n - 답변은 인지 장애인들이 겪는 어려움과 관련 있게 생성한다.\n - 욕설, 차별적 요소, 부적절한 언어들은 제외한다.\n - 해당 다변은 반드시 리스트나 배열에 사용할 수 있도록 다음과 같은 형식으로 출력한다.\n"}]
for idx,question in enumerate(question_lst):
preset_text.append({"role" : "user", "content" : f"{val}"})
request_data = {
'messages': preset_text,
'topP': 0.8,
'topK': 0,
'maxTokens': 256,
'temperature': 0.5,
'repeatPenalty': 5.0,
'stopBefore': [],
'includeAiFilters': True,
'seed': 0
}
content = completion_executor.execute(request_data)
print(f"답변 생성 결과 : {content}")
print("-------------")
df.loc[idx,'Completion'] = content
del preset_text[-1]
print(df)
#df.to_csv("c:/tmp/courses.csv", index=False)
Python
복사
최종 코드는 아래와 같습니다.
1.
질문들이 존재하는 dataset들을 pd.read_csv로 불러옵니다.
2.
NaverCLOVA에서 튜닝한 API를 이용해서 답변을 생성합니다.
3.
해당 답변들을 생성하고 dataframe의 column으로 추가해서 datasets.csv파일로 저장합니다.
import json
import requests
import pandas as pd
class CompletionExecutor:
def __init__(self, host, api_key, api_key_primary_val, request_id):
self._host = host
self._api_key = api_key
self._api_key_primary_val = api_key_primary_val
self._request_id = request_id
def execute(self, completion_request):
headers = {
'X-NCP-CLOVASTUDIO-API-KEY': self._api_key,
'X-NCP-APIGW-API-KEY': self._api_key_primary_val,
'X-NCP-CLOVASTUDIO-REQUEST-ID': self._request_id,
'Content-Type': 'application/json; charset=utf-8',
'Accept': 'text/event-stream'
}
content = ""
with requests.post(self._host + '/testapp/v1/tasks/4ce94y7k/chat-completions', headers=headers, json=completion_request, stream=True) as r:
for line in r.iter_lines():
if line:
decoded_line = line.decode("utf-8")
if decoded_line.startswith("data:"):
json_data = decoded_line[5:] # 'data:' 이후의 JSON 데이터 추출
try:
parsed_data = json.loads(json_data)
if 'message' in parsed_data and 'content' in parsed_data['message']:
if content == parsed_data['message']['content']:
pass
else:
content += parsed_data['message']['content']
except json.JSONDecodeError:
# JSON 형식이 맞지 않을 경우 무시
continue
return content
if __name__ == '__main__':
completion_executor = CompletionExecutor(
host='https://clovastudio.stream.ntruss.com',
api_key='NTA0MjU2MWZlZTcxNDJiY5OgY4I/+eAv267dQbt+9aDUE0J6DJ/sL2uIey9+AkMG',
api_key_primary_val='dn7QeKh9ZQNxR782O4jPEUU02ae6esNz3DhLUsF2',
request_id='fc9998a2-5db4-4661-bbfe-887a78a6be7a'
)
path = r"C:\Users\sook3\OneDrive\바탕 화면\something\학습\DEL 과제\국립재활연구원_2408\chatbot 만들기\datasets.csv"
df = pd.read_csv(path)
questions_lst = df['Text']
preset_text = [{"role":"system","content":"당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다\n 당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다. \n ### 답변 생성 방법 ### \n - 대화체로 생성한다.\n - 답변은 인지 장애인들이 겪는 어려움과 관련 있게 생성한다.\n - 욕설, 차별적 요소, 부적절한 언어들은 제외한다.\n - 해당 다변은 반드시 리스트나 배열에 사용할 수 있도록 다음과 같은 형식으로 출력한다.\n"}]
for idx,question in enumerate(questions_lst):
preset_text.append({"role" : "user","content" : f"{question}"})
request_data = {
'messages': preset_text,
'topP': 0.8,
'topK': 0,
'maxTokens': 256,
'temperature': 0.5,
'repeatPenalty': 5.0,
'stopBefore': [],
'includeAiFilters': True,
'seed': 0
}
content = completion_executor.execute(request_data)
print(f"답변 생성 결과: {content}")
print("----------------------------------")
df.loc[idx,'Completion'] = content
del preset_text[-1]
#print(df)
df.to_csv(path, index =False, encoding = "utf-8-sig") # 위에 첨부했습니다.
Python
복사
MySQL DB와 연결시켜보기
DB로부터 어떠한 상황인지를 LLM에게 브리핑해서 맞춤형으로 대화를 생성하려면?
단순 대화 모델에 상황을 인지시켜서 맞춤형 대화모델이 되는지 테스트해보자.

import json
import requests
import pandas as pd
import mysql.connector
import time
Python
복사
DB에서 사용자 정보를 가져오기 위해서 추가한 부분
( user_id를 입력하면, 해당 정보를 가져오는 함수)
def get_user_info(user_id):
connection = mysql.connector.connect(
host = 'localhost',
user = 'hanshin',
password = 'hanshin2024',
database = 'users')
cur = connection.cursor()
cur.execute("SELECT name, disability_type, preferences FROM users WHERE user_id =?",(user_id,))
user_info = cur.fetchone()
connection.close()
if user_info:
return {
'name' : user_info[0],
'disability_type' : user_info[1],
'preferences' : user_info[2]
}
else:
return None
Python
복사
실행 코드에 get_user_info 함수 적용하기
if __name__ == '__main__':
completion_executor = CompletionExecutor(
host='https://clovastudio.stream.ntruss.com',
api_key='NTA0MjU2MWZlZTcxNDJiY5OgY4I/+eAv267dQbt+9aDUE0J6DJ/sL2uIey9+AkMG',
api_key_primary_val='dn7QeKh9ZQNxR782O4jPEUU02ae6esNz3DhLUsF2',
request_id='fc9998a2-5db4-4661-bbfe-887a78a6be7a'
)
path = r"C:\Users\sook3\OneDrive\바탕 화면\something\학습\DEL 과제\국립재활연구원_2408\chatbot 만들기\datasets.csv"
df = pd.read_csv(path)
questions_lst = df['Text']
# preset_text = [{"role":"system","content":"당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다\n 당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다. \n ### 답변 생성 방법 ### \n - 대화체로 생성한다.\n - 답변은 인지 장애인들이 겪는 어려움과 관련 있게 생성한다.\n - 욕설, 차별적 요소, 부적절한 언어들은 제외한다.\n - 해당 다변은 반드시 리스트나 배열에 사용할 수 있도록 다음과 같은 형식으로 출력한다.\n"}]
for idx,question in enumerate(questions_lst):
user_info = get_user_info(user_id = 1)
if not user_info:
print("User info not found for user_id ")
continue
preset_text = [{"role":"system", "content" : f"""당신은 {user_info['name']}님을 도와주는 챗봇입니다. {user_info['name']}님은 {user_info['disability_type']}을 가지고 있습니다. 다음 대화에서는 이 정보를 바탕으로 대화하세요.\n
- 선호도: {user_info['preferences']} \n
### 답변 생성 방법 ### \n
- 대화체로 생성한다.\n
- 답변은 사용자의 disability_type과 관련된 어려움에 관련 있게 생성한다.\n
- 욕설, 차별적 요소, 부적절한 언어들은 제외한다.\n
- 해당 답변은 반드시 리스트나 배열에 사용할 수 있도록 출력한다.\n
- 답변에 사용자의 이름을 불러주는 역할을 추가한다.\n
- 답변에 사용자의 선호도를 반영하여 적절한 답변을 생성한다."""}
]
preset_text.append({"role" : "user","content" : f"{question}"})
request_data = {
'messages': preset_text,
'topP': 0.8,
'topK': 0,
'maxTokens': 256,
'temperature': 0.5,
'repeatPenalty': 5.0,
'stopBefore': [],
'includeAiFilters': True,
'seed': 0
}
content = completion_executor.execute(request_data)
print(f"답변 생성 결과: {content}")
print("----------------------------------")
df.loc[idx,'Completion'] = content
time.sleep(1)
del preset_text[-1]
#print(df)
df.to_csv(path, index =False, encoding="utf-8-sig")
Python
복사

<현재는 DB를 생성하지 않았으므로, 아래와 같은 에러가 발생한다.> |
---------------------------------------------------------------------------
OperationalError Traceback (most recent call last)
Cell In[13], line 16
13 # preset_text = [{"role":"system","content":"당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다\n 당신은 인지에 장애가 있는 장애인들이 일상생활에서 겪는 어려움을 해결해주는 챗봇입니다. \n ### 답변 생성 방법 ### \n - 대화체로 생성한다.\n - 답변은 인지 장애인들이 겪는 어려움과 관련 있게 생성한다.\n - 욕설, 차별적 요소, 부적절한 언어들은 제외한다.\n - 해당 답변은 반드시 리스트나 배열에 사용할 수 있도록 다음과 같은 형식으로 출력한다.\n"}]
15 for idx,question in enumerate(questions_lst):
---> 16 user_info = get_user_info(user_id = 1)
18 if not user_info:
19 print("User info not found for user_id ")
Cell In[10], line 5
2 connection = sqlite3.connect('user_data.db')
3 cur = connection.cursor()
----> 5 cur.execute("SELECT name, disability_type, preferences FROM users WHERE user_id =?",(user_id,))
6 user_info = cur.fetchone()
8 connection.close()
OperationalError: no such table: users |
그렇다면 실제 user DB를 만들어서 연동시켜보자.


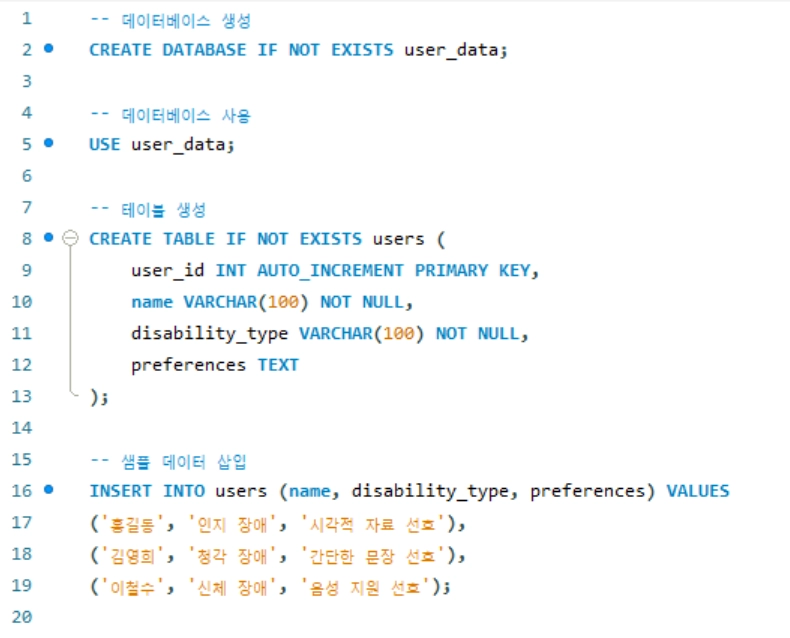
-- 데이터베이스 생성
CREATE DATABASE IF NOT EXISTS user_data;
-- 데이터베이스 사용
USE user_data;
-- 테이블 생성
CREATE TABLE IF NOT EXISTS users (
user_id INT AUTO_INCREMENT PRIMARY KEY,
name VARCHAR(100) NOT NULL,
disability_type VARCHAR(100) NOT NULL,
preferences TEXT
);
-- 샘플 데이터 삽입
INSERT INTO users (name, disability_type, preferences) VALUES
('홍길동', '인지 장애', '시각적 자료 선호'),
('김영희', '청각 장애', '간단한 문장 선호'),
('이철수', '신체 장애', '음성 지원 선호');
|
ClovaStudio STT 이해하기
import requests
import json
class ClovaSpeechClient:
# Clova Speech invoke URL
invoke_url = 'https://clovaspeech-gw.ncloud.com/external/v1/8983/54d5b161d3da62f82f3592398295d44524110cfef1b81e5ca3dae43e79f634d0'
secret = 'b256e2de4b3a4898b3f020894236934f'
# 외부 URL을 text로 전환
def req_url(self,url, completion, callback=None, userdata =None, forbiddens=None,boostings=None, wordAlignment=True, fullText=True, diarization=None, sed=None ):
request_body = {
'url': url,
'language': 'ko-KR',
'completion': completion,
'callback': callback,
'userdata': userdata,
'wordAlignment': wordAlignment,
'fullText': fullText,
'forbiddens': forbiddens,
'boostings': boostings,
'diarization': diarization,
'sed': sed,
}
headers = {
'Accept': 'application/json;UTF-8',
'Content-Type': 'application/json;UTF-8',
'X-CLOVASPEECH-API-KEY': self.secret
}
return requests.post(headers=headers,
url=self.invoke_url + '/recognizer/url',
data=json.dumps(request_body).encode('UTF-8'))
# 클라두으 스토리지에 저장되어 있는 파일을 text로 전환
def req_object_storage(self, data_key, completion, callback=None, userdata=None, forbiddens=None, boostings=None,
wordAlignment=True, fullText=True, diarization=None, sed=None):
request_body = {
'dataKey': data_key,
'language': 'ko-KR',
'completion': completion,
'callback': callback,
'userdata': userdata,
'wordAlignment': wordAlignment,
'fullText': fullText,
'forbiddens': forbiddens,
'boostings': boostings,
'diarization': diarization,
'sed': sed,
}
headers = {
'Accept': 'application/json;UTF-8',
'Content-Type': 'application/json;UTF-8',
'X-CLOVASPEECH-API-KEY': self.secret
}
return requests.post(headers=headers,
url=self.invoke_url + '/recognizer/object-storage',
data=json.dumps(request_body).encode('UTF-8'))
# 로컬 저장소에 있는 파일을 text로 전환
def req_upload(self, file, completion, callback=None, userdata=None, forbiddens=None, boostings=None,
wordAlignment=True, fullText=True, diarization=None, sed=None):
request_body = {
'language': 'ko-KR',
'completion': completion,
'callback': callback,
'userdata': userdata,
'wordAlignment': wordAlignment,
'fullText': fullText,
'forbiddens': forbiddens,
'boostings': boostings,
'diarization': diarization,
'sed': sed,
}
headers = {
'Accept': 'application/json;UTF-8',
'X-CLOVASPEECH-API-KEY': self.secret
}
print(json.dumps(request_body, ensure_ascii=False).encode('UTF-8'))
files = {
'media': open(file, 'rb'),
'params': (None, json.dumps(request_body, ensure_ascii=False).encode('UTF-8'), 'application/json')
}
response = requests.post(headers=headers, url=self.invoke_url + '/recognizer/upload', files=files)
return response
if __name__ == '__main__':
# res = ClovaSpeechClient().req_url(url='http://example.com/media.mp3', completion='sync')
# res = ClovaSpeechClient().req_object_storage(data_key='data/media.mp3', completion='sync')
""" file에 인식하고자 하는 파일의 경로를 입력하기 """
res = ClovaSpeechClient().req_upload(file='./data/서영은 - 꿈을 꾼다.m4a', completion='sync')
print(res.text)
Python
복사
해당 내용은 거의 API처럼 CLOVA에서 제공해주고 있으니, 서영은 - 꿈을 꾼다 노래 파일을 변환해보자.
Terminal 결과
Text 결과

TTS 성능이라기 보단 음원이라서 성공률이 낮다고 이해해야 하나? 일반 음성으로도 시험을 해보아야겠네. 그래도 생각보다 노래도 잘 변환해주는 것 같아.
