






 문제 해결 과정
1.
블로그 참조해서 따라해보기
2.
각 과정을 서로 연결시켜보기 ⇒ (240905 회의내용 : https://www.notion.so/240905-a6999458631f4021a94a6c35e55e46fd?pvs=4)
 결과

결과
 최종 코드는 아래와 같습니다.
1.

결과 파일
import requests
import json
Python
복사

class ClovaSpeechClient:
# Clova Speech invoke URL
invoke_url = 'https://clovaspeech-gw.ncloud.com/external/v1/8983/54d5b161d3da62f82f3592398295d44524110cfef1b81e5ca3dae43e79f634d0'
secret = 'b256e2de4b3a4898b3f020894236934f'
# 외부 URL을 text로 전환
def req_url(self,url, completion, callback=None, userdata =None, forbiddens=None,boostings=None, wordAlignment=True, fullText=True, diarization=None, sed=None ):
request_body = {
'url': url,
'language': 'ko-KR',
'completion': completion,
'callback': callback,
'userdata': userdata,
'wordAlignment': wordAlignment,
'fullText': fullText,
'forbiddens': forbiddens,
'boostings': boostings,
'diarization': diarization,
'sed': sed,
}
headers = {
'Accept': 'application/json;UTF-8',
'Content-Type': 'application/json;UTF-8',
'X-CLOVASPEECH-API-KEY': self.secret
}
return requests.post(headers=headers,
url=self.invoke_url + '/recognizer/url',
data=json.dumps(request_body).encode('UTF-8'))
# 클라두으 스토리지에 저장되어 있는 파일을 text로 전환
def req_object_storage(self, data_key, completion, callback=None, userdata=None, forbiddens=None, boostings=None,
wordAlignment=True, fullText=True, diarization=None, sed=None):
request_body = {
'dataKey': data_key,
'language': 'ko-KR',
'completion': completion,
'callback': callback,
'userdata': userdata,
'wordAlignment': wordAlignment,
'fullText': fullText,
'forbiddens': forbiddens,
'boostings': boostings,
'diarization': diarization,
'sed': sed,
}
headers = {
'Accept': 'application/json;UTF-8',
'Content-Type': 'application/json;UTF-8',
'X-CLOVASPEECH-API-KEY': self.secret
}
return requests.post(headers=headers,
url=self.invoke_url + '/recognizer/object-storage',
data=json.dumps(request_body).encode('UTF-8'))
# 로컬 저장소에 있는 파일을 text로 전환
def req_upload(self, file, completion, callback=None, userdata=None, forbiddens=None, boostings=None,
wordAlignment=True, fullText=True, diarization=None, sed=None):
request_body = {
'language': 'ko-KR',
'completion': completion,
'callback': callback,
'userdata': userdata,
'wordAlignment': wordAlignment,
'fullText': fullText,
'forbiddens': forbiddens,
'boostings': boostings,
'diarization': diarization,
'sed': sed,
}
headers = {
'Accept': 'application/json;UTF-8',
'X-CLOVASPEECH-API-KEY': self.secret
}
print(json.dumps(request_body, ensure_ascii=False).encode('UTF-8'))
files = {
'media': open(file, 'rb'),
'params': (None, json.dumps(request_body, ensure_ascii=False).encode('UTF-8'), 'application/json')
}
response = requests.post(headers=headers, url=self.invoke_url + '/recognizer/upload', files=files)
return response
Python
복사

if __name__ == '__main__':
# res = ClovaSpeechClient().req_url(url='http://example.com/media.mp3', completion='sync')
# res = ClovaSpeechClient().req_object_storage(data_key='data/media.mp3', completion='sync')
""" file에 인식하고자 하는 파일의 경로를 입력하기 """
res = ClovaSpeechClient().req_upload(file='./data/서영은 - 꿈을 꾼다.m4a', completion='sync')
print(res.text)
Python
복사
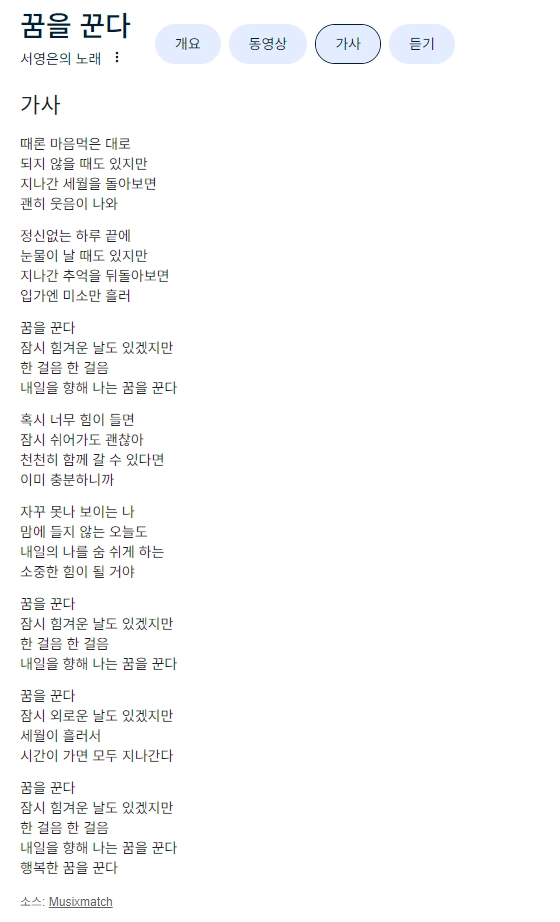
서영은 ‘꿈을 꾼다’ m4a 파일 speech to text 변환 결과
"text":
"때로 마음먹은 대로 되지 않은 해도 일
간 세월을 돌아보며
괜히 웃음이 나와
정신없는 하루 끝에
눈물이 날 따돌
뒤돌아보며
미소 꿈을 꾼다.
잠시 힘겨워
한 걸음 한 걸음
내일을 향 나는 꿈을 다.
혹시 너무 힘이 들면
잠시 쉬어 아파도 괜찮아.
천천히 함께 갈 수 있다면
이미 충분하니까
자꾸 못나 보이는 날
마음에 들지 않는
소중한 힘이 될 거야.
다 잠시 힘겨운 날도 있겠지만
한 걸음 한 걸음
내일을 향해 나는 꿈을 꾼다.
잠시 외로운 날도 있겠지만,
세월이 흘러서
시간이 가면 모두 지나
다 잠시 힘겨운 날도 있겠지만
한 걸음 한 걸음
내일을 향해
나는 오늘 다 행복한 꿈을."

해결되지 않은 점
