






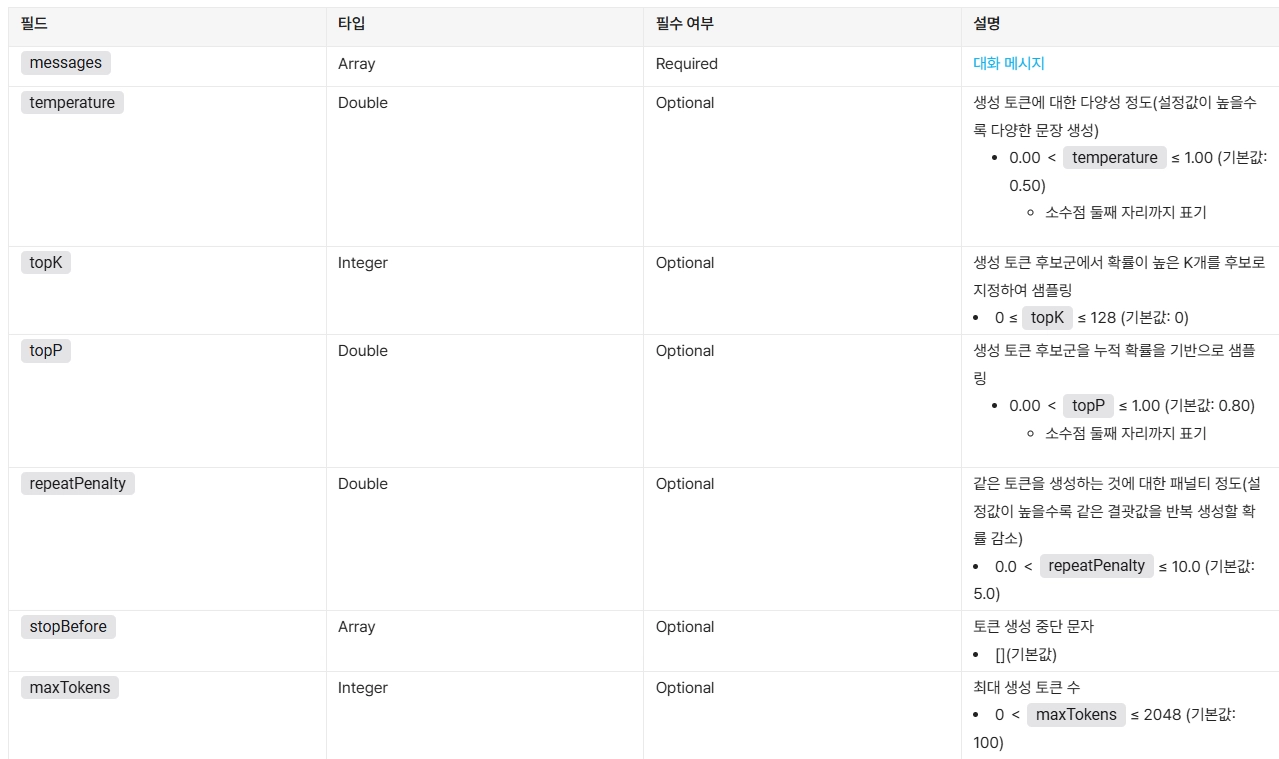
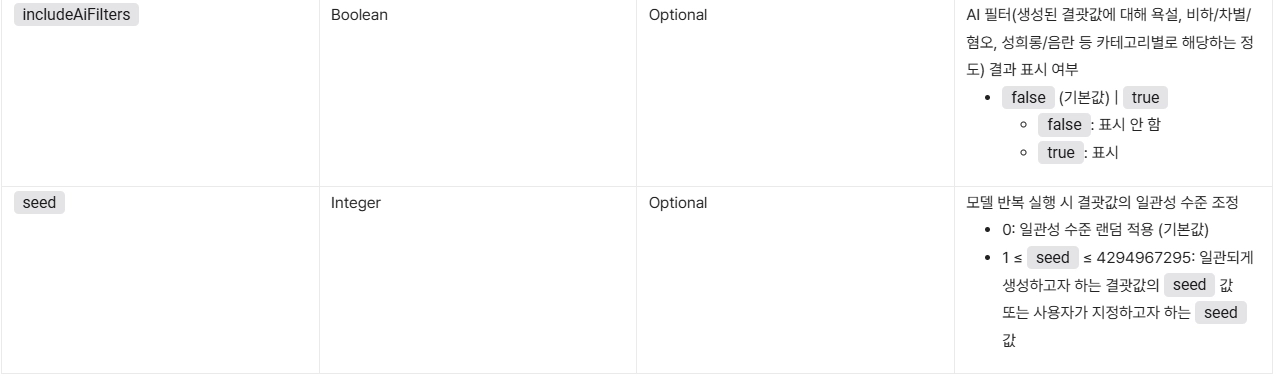

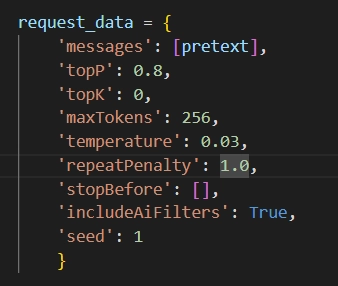
temperature : 0.5 → 0.03, repeatPenalty : 5.0 → 1.0, seed : 0 → 1
우선 seed를 0대신 다른 정수 값(1~4294967295)을 사용하니 결과가 거의 일관되게 나오게 됨
temperature와 repeatPenalty부분도 낮추면 더욱 일관성이 높아질 수 있음


데이터셋
데이터셋 (csv 파일)
튜닝모델 만들기

•
241022test 버킷에 csv파일을 업로드합니다.
•
아래 tunning_241022.py를 실행합니다.
⇒ 버킷에 저장된 데이터셋을 기준으로 튜닝 모델을 만드는 코드입니다.
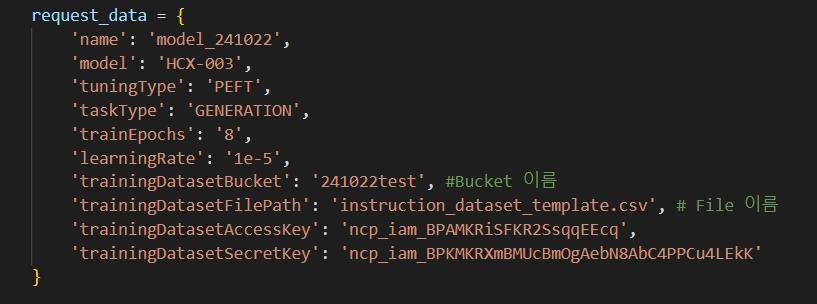
만약 필요시 해당 부분을 수정합니다.

name : 모델 이름
trainingDatasetBucket : 버킷 이름
trainingDatasetFilePath : 데이터셋 csv파일 이름
•
소스코드가 실행 완료되면,
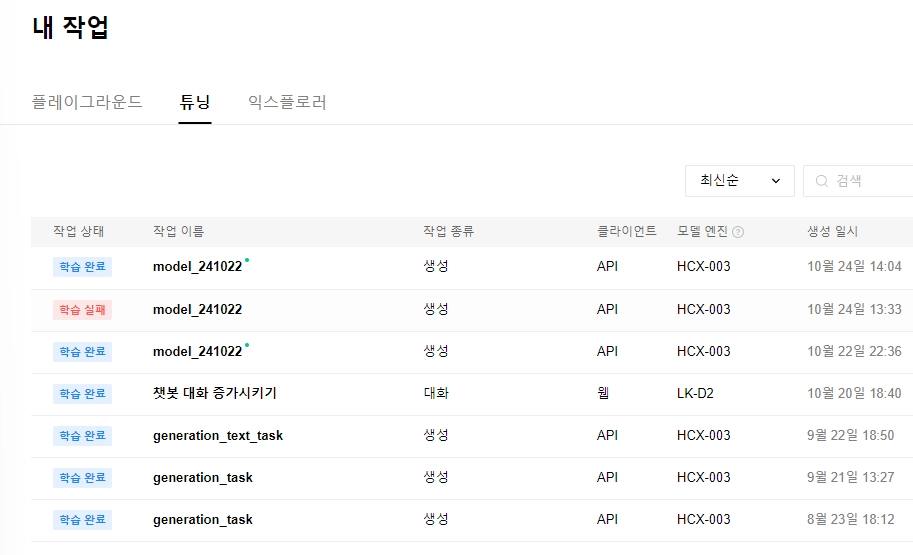
해당 부분에 학습 대기로 새로 생성이 됩니다.
작업 상태가 학습 완료가 될 때까지 대기해주세요.
•
불러오기를 클릭한 다음
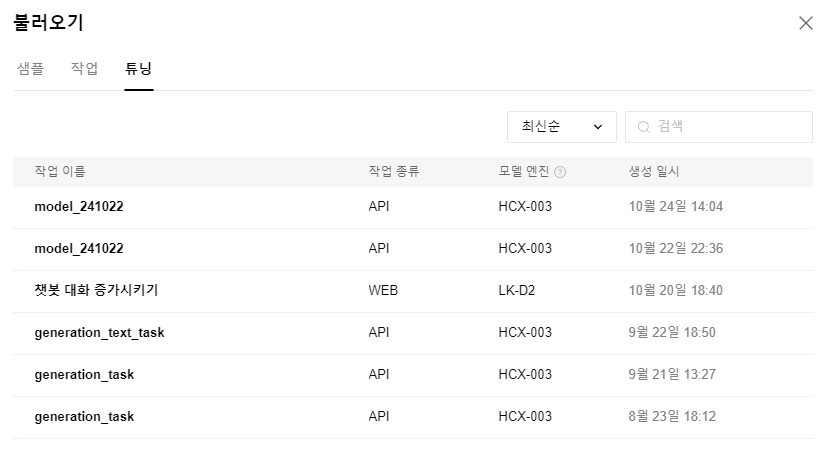
튜닝에서 자신이 학습한 모델 이름을 클릭합니다.
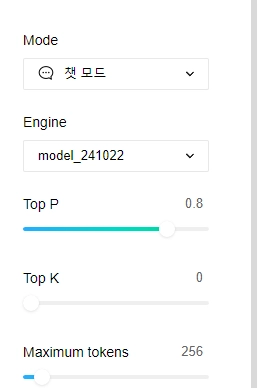
그럼 Engine이 자신이 튜닝한 모델로 변경됩니다.
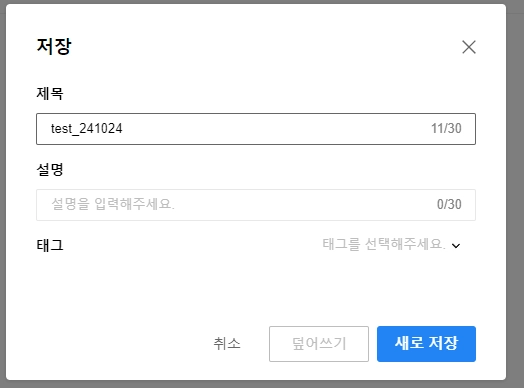
그리고 원하시는 제목을 설정해서 새로 저장을 클릭합니다.
그 다음 테스트앱을 클릭합니다.
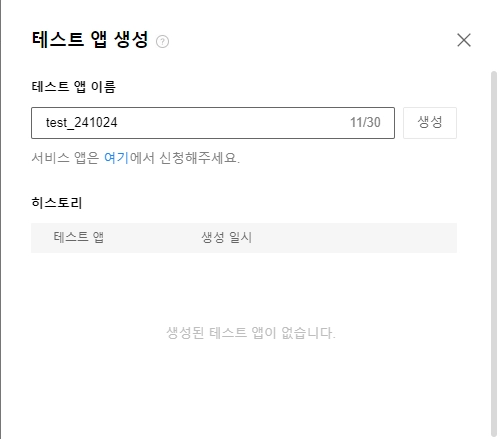
여기서도 원하는 이름으로 테스트 앱 이름을 설정하고 생성합니다.
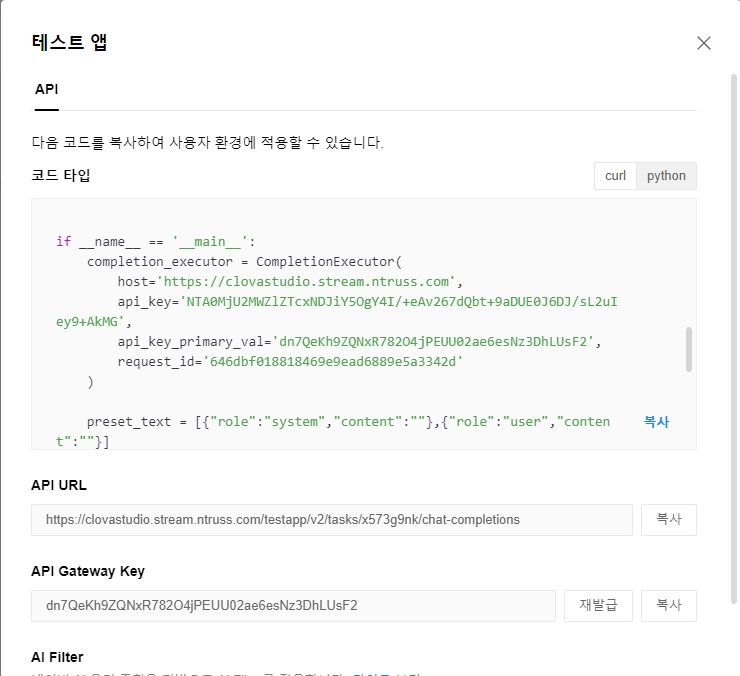
그 후, 아래 소스 코드만 변경해주면 완료가 됩니다.
completion_executor = CompletionExecutor(
host='https://clovastudio.stream.ntruss.com',
api_key='NTA0MjU2MWZlZTcxNDJiY5OgY4I/+eAv267dQbt+9aDUE0J6DJ/sL2uIey9+AkMG',
api_key_primary_val='dn7QeKh9ZQNxR782O4jPEUU02ae6esNz3DhLUsF2',
request_id='646dbf018818469e9ead6889e5a3342d'
)
Python
복사

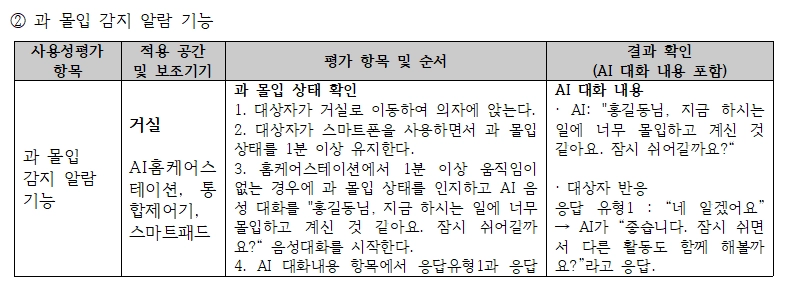
과몰입 시나리오
초기 버전
•
Case 1

홍길동님 지금 하시는 일에 너무 몰입하고 계신 것 같아요. 잠시 쉬어갈까요?
네, 알겠어요.
알겠습니다.
네, 그럴게요.
좋아요, 그렇게 할게요.
네, 잠시 쉬어가죠.
네, 그렇게 하겠습니다.
그렇게 하죠.
좋습니다. 잠시 쉬면서 다른 활동도 함께 해볼까요?
•
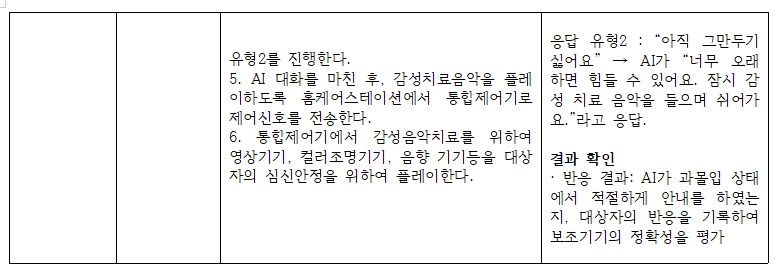
Case 2
홍길동님 지금 하시는 일에 너무 몰입하고 계신 것 같아요. 잠시 쉬어갈까요?
아직 그만두기 싫어요.
아직 끝내고 싶지 않아요.
조금 더 할 수 있어요.
조금만 더 해볼게요.
계속 해보고 싶어요.
조금 더 집중하고 싶어요.
너무 오래하면 힘들 수 있어요. 잠시 감성 치료 음악을 들으며 쉬어가요.

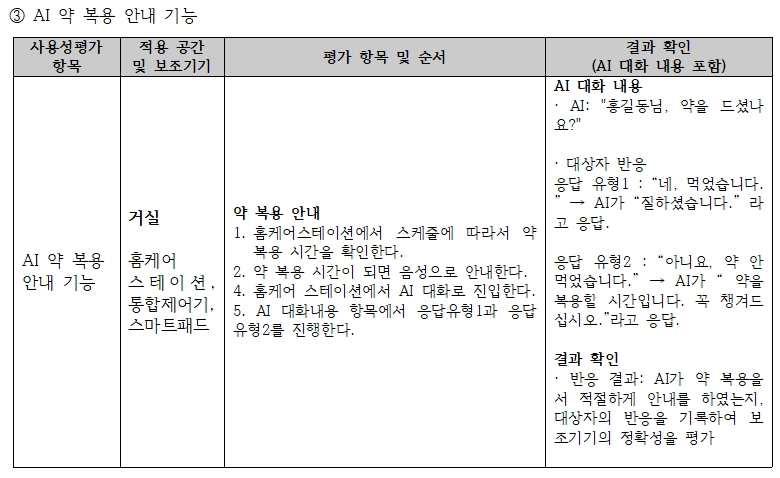
약 복용 확인 시나리오
•
Case 1
홍길동님, 약을 드셨나요?
네, 먹었습니다.
예, 챙겨 먹었어요.
네, 약 먹었습니다.
네, 잊지 않고 먹었어요.
잘하셨습니다.
•
Case 2
홍길동님, 약을 드셨나요?
아니요, 약 안 먹었습니다.
아니요, 아직 안 먹었어요.
아니요, 깜빡했어요.
아직 복용하지 않았어요.
아직 먹지 않았어요. 조금 있다가 먹으려고 해요.
아직 못 먹었어요. 잊어버렸네요.
아직 안 먹었어요. 시간이 없었거든요.
아, 아직 못 챙겨 먹었네요. 금방 먹을게요!
약을 복용할 시간입니다. 꼭 챙겨드십시오.
