



1. AutoML이란?
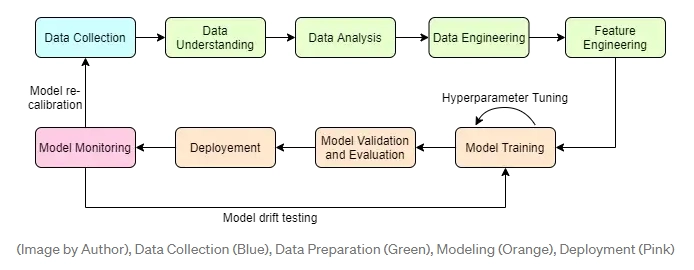
AutoML이란 Automated Machine Learning의 약자로, 머신러닝 모델 개발을 자동화하기 위한 기술 분야이다.
•
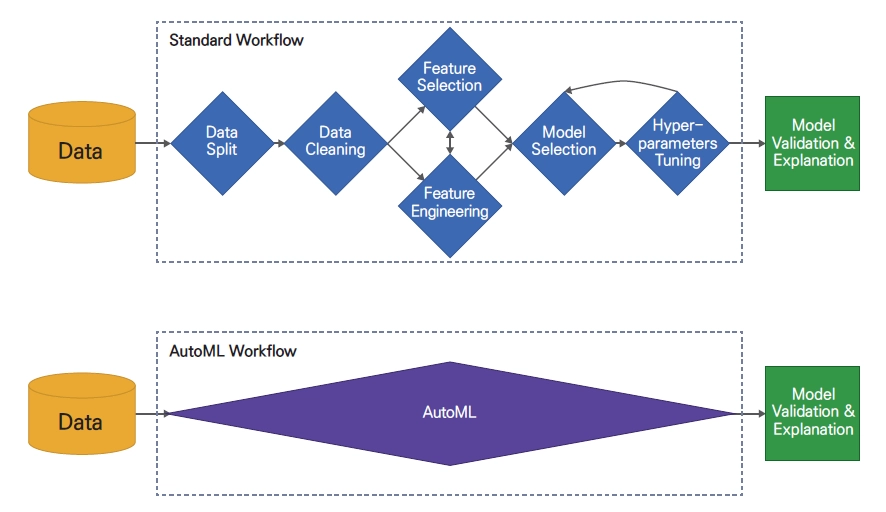
주어진 데이터 셋에 가장 적합한 하이퍼파라미터 셋과 가장 잘 맞는 모델을 찾아준다.
•
많은 머신러닝 모델 개발 과제에서 반복적으로 수행하게 되는 데이터 분할, 정제, 특징 선택 및 추출, 모델 선택, 하이퍼 파라미터 튜닝 등을 함수화하여 자동화한다.
•
AutoML은 인공지능 모델을 만드는 인공지능이라고 할 수 있다.
•
Model drift: 변화하는 환경에 따라 모델의 성능이 저하되는 현상
2. AutoML Frameworks & Libraries
2-1. Auto-Sklearn
•
Scikit-learn package에서 만들어진 오픈 소스 AutoML library이다.
•
대형 데이터 셋에서 잘 작동하지 않고 중소형 데이터 셋에서 잘 작동한다.
2-2. TPOT
•
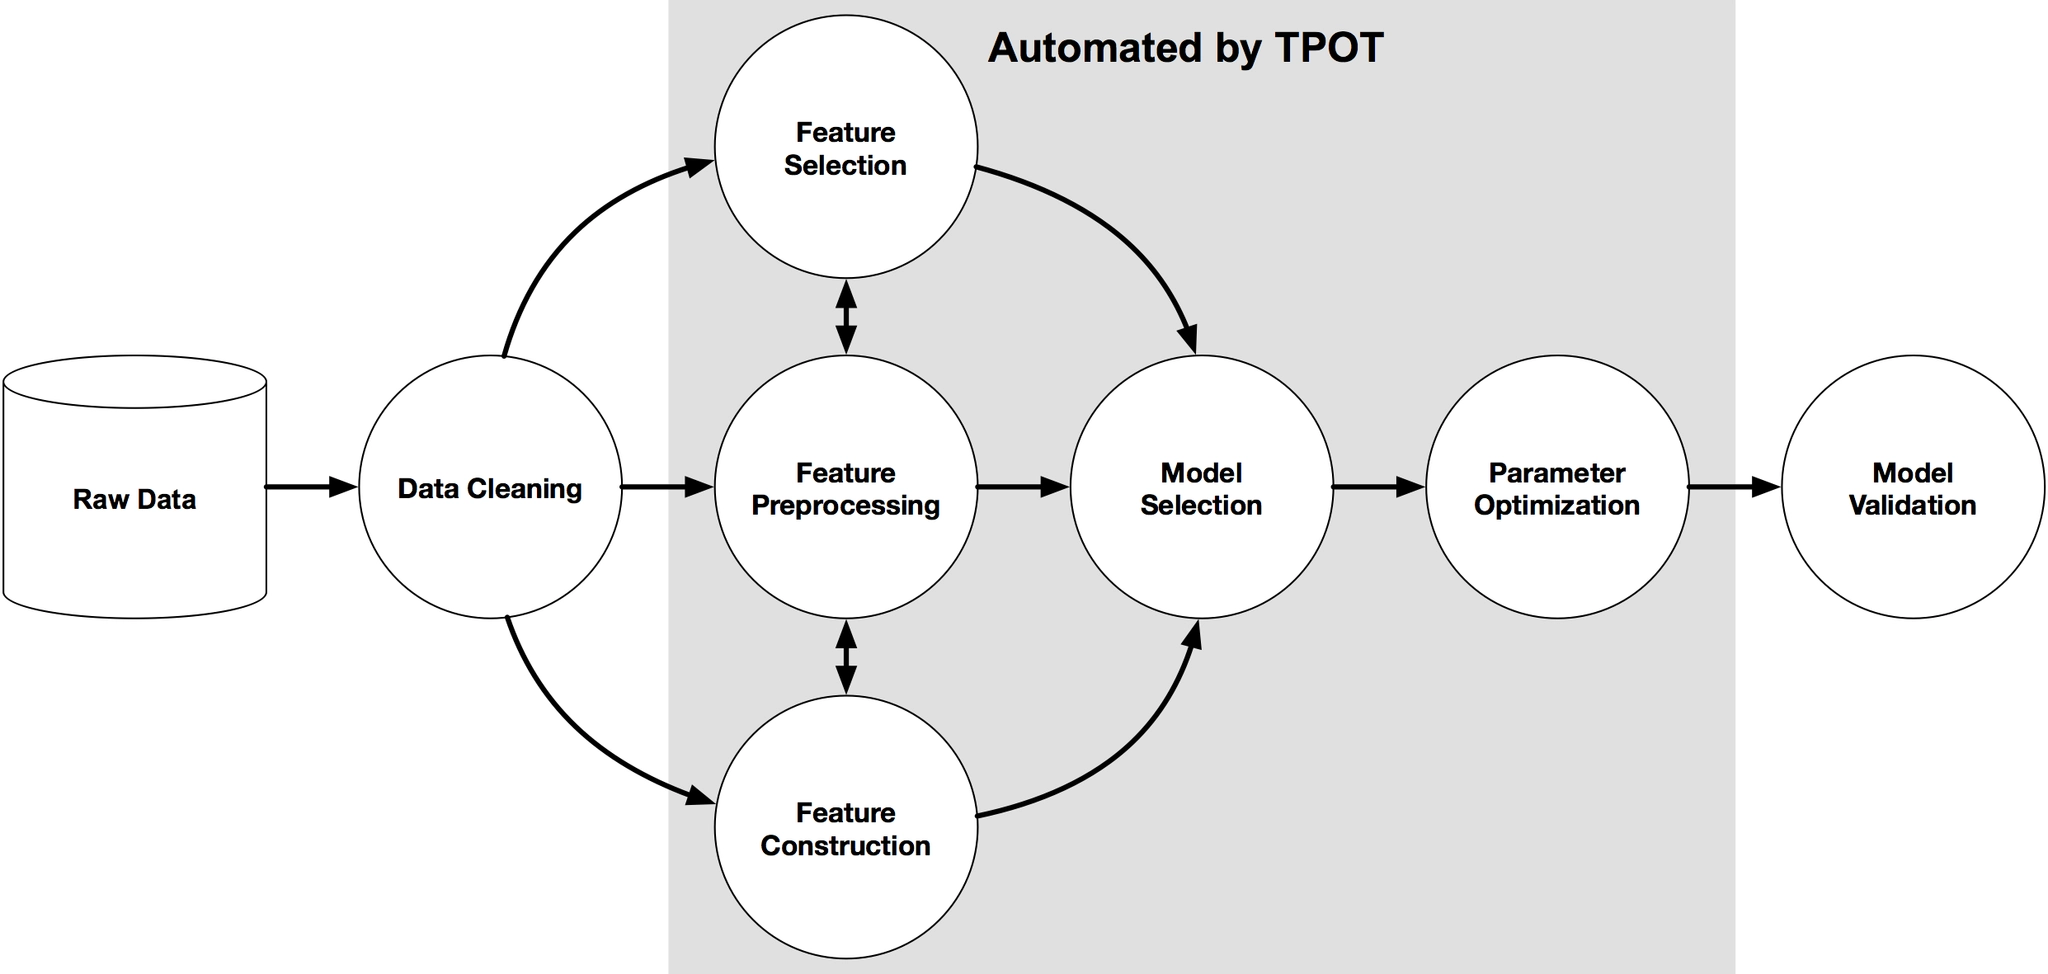
TPOT은 트리 기반의 파이프 라인 최적화 도구를 나타낸다.
•
또한, 유전자 프로그래밍을 사용하여 기계 학습 파이프 라인을 최적화하는 오픈 소스 Python AutoML 도구이다.
•
Data Cleaning (데이터 정제)는 TPOT 아키텍쳐 외부에 있다.
•
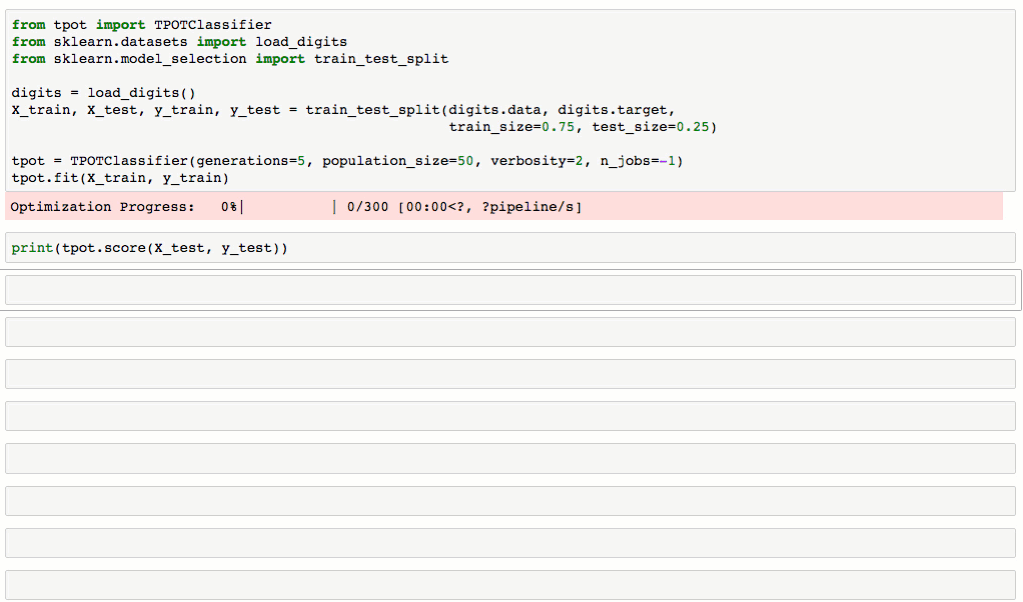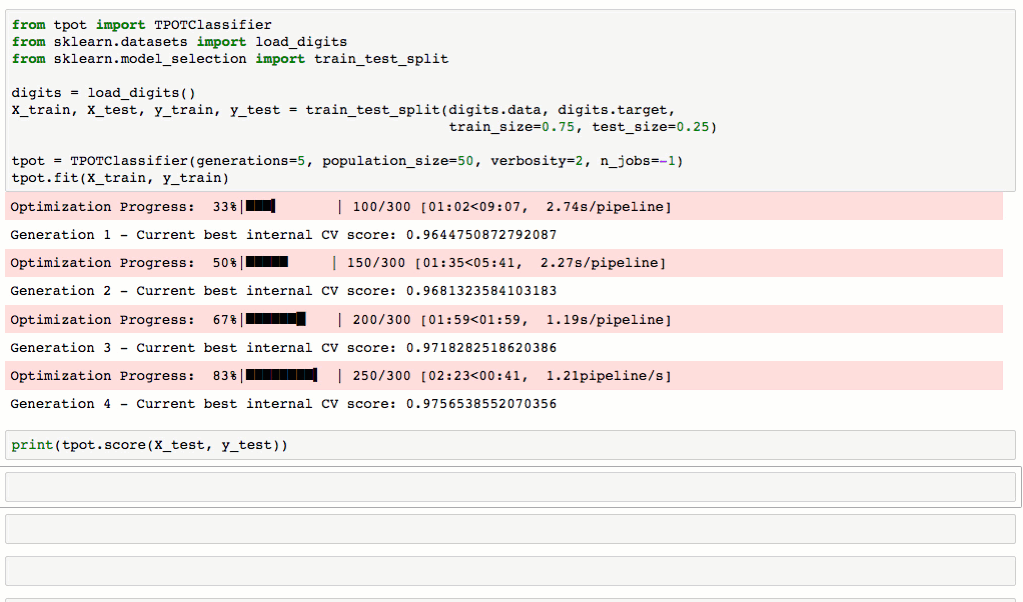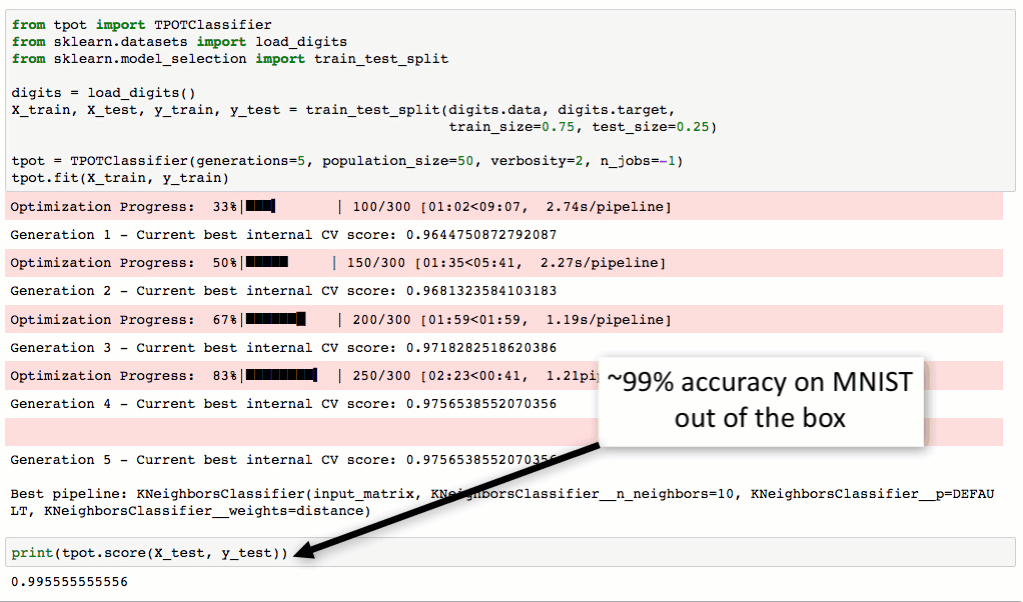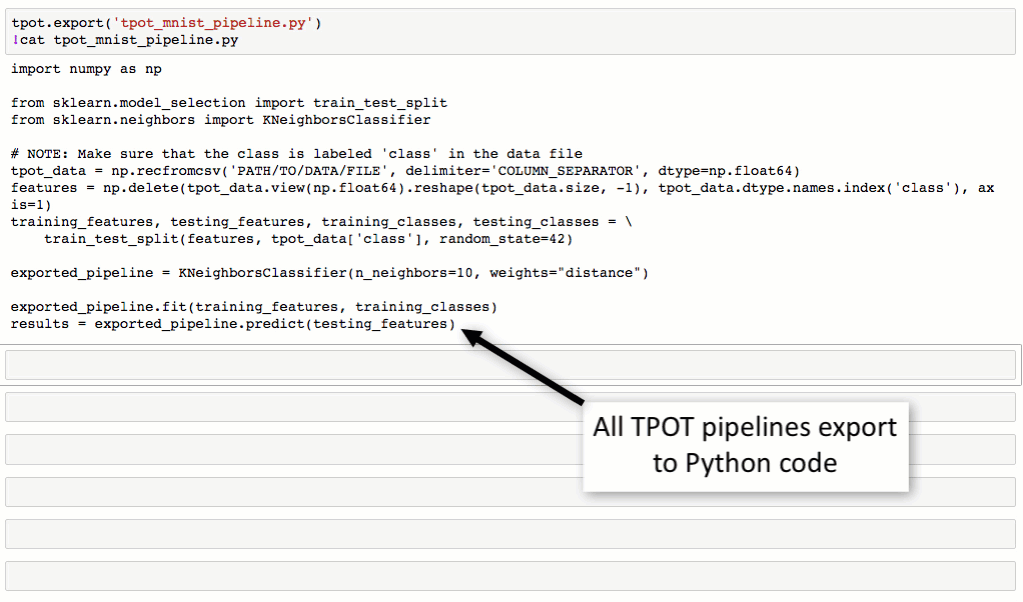
TPOT이 검색을 마치면(또는 기다리는 데 지치면) TPOT이 찾은 최상의 파이프라인에 대한 Python 코드를 제공하므로 여기에서 파이프라인을 수정할 수 있습니다.
•
누락된 값 처리, 데이터 셋을 숫자 형식으로 변환하는 작업은 데이터 과학자가 직접 해야 한다.
2-3. Auto-ViML (Automated Variant Implementation Machine Learning)
•
TPOT AutoML 도구의 한계는 숫자 형식의 데이터 세트를 예상하고 누락된 값 처리 및 데이터 정리 항목은 TPOT 구현 전에 완료되어야 한다는 것이다.
•
이러한 점에서 AutoViML은 인코딩 데이터 세트, 기능 선택 및 기타 데이터 정리 활동을 처리하므로 이 문제를 극복 가능하다.
•
AutoViML은 TPOT보다 비교적 빠르며 모델 선택 및 하이퍼파라미터 최적화와 함께 여러 그래픽 결과를 생성한다.
2-4. H2O AutoML
•
H2O에서 개발한 프레임워크로 기계 학습 워크 플로우를 자동화하는데 사용할 수 있다.
•
숫자 인코딩, 누락된 값 대치 및 기타 전처리 워크 플로우와 같은 데이터 전처리가 수행 가능하다.
•
자동으로 모델 선택 및 하이퍼파라미터 튜닝을 수행하고 성능과 함께 모델의 순위표 보기로 돌아간다.
•
즉시 사용할 수 있는 배포 코드를 제공한다.
•
H2O는 자바로 개발되었기 때문에 자바 런타임 환경이 필요하다.
2-5. Auto-Keras
•
Texas A&M University의 Datalab 팀에서 개발한 딥러닝 프레임워크인 Keras 위에 구축된 오픈 소스 AutoML library이다.
•
분류 및 회귀를 위한 최고 성능의 딥러닝 모델을 찾기 위해 구축되었다.
•
딥러닝 모델을 위한 아키텍처와 하이퍼파라미터를 자동으로 검색하여 트레이닝 데이터를 사용하여 트레이닝하고 가장 성능이 좋은 딥러닝 모델을 최종 결과로 반환한다.
•
고전적인 Scikit-Learn API 설계를 따르므로 사용하기 쉽다.
2-6. MLBox
•
AutoML Python Library이다.
•
기능 선택, 누락된 값 대치 및 이상치 감지에 탁월하다.
•
최적화되고 빠른 데이터 전처리가 가능하다.
•
자동으로 하이퍼파라미터를 최적화하고 분류 및 회귀를 위한 모델을 자동으로 선택한다.
•
해석을 통한 모델을 예측한다.
•
다른 AutoML library와 비교하여 MLBox는 범주형 기능에 Entity Embedding을 사용하여 누락된 값 대치를 수행한다.
•
모델 선택 및 하이퍼파라미터 최적화와 함께 훈련 데이터의 분포를 테스트 데이터와 유사하게 만드는 것이 목적이다.
2-7. Hyperopt Sklearn
•
HyperOpt-Sklearn은 Bayesian Optimization을 위한 오픈 소스 Python library인 HyperOpt library를 래핑한다.
•
하이퍼파라미터가 많은 모델의 대규모 최적화를 위해 설계된 Python library이다.
•
여러 코어에 걸쳐 확장할 수 있는 최적화 절차를 따르기 때문에 대규모 모델에 적합하다.
•
데이터 전처리, 모델 선택 및 하이퍼파라미터 튜닝을 포함하여 기계 학습 파이프라인을 최적화한다.
•
데이터 준비 방법, 기계 학습 알고리즘 및 모델 하이퍼파라미터를 자동으로 검색 가능하다. 가장 성능이 좋은 분류 및 회귀 모델을 찾는 데 적합하다.
2-8. AutoGluon
•
AutoGluon은 AWS에서 오픈 소스로 제공하는 딥러닝 워크로드용으로 개발된 프레임워크이다.
•
테이블 형식 데이터만 지원하는 다른 AutoML library와 달리 이미지 분류, 객체 감지, 텍스트 및 이미지에 걸친 실제 애플리케이션도 지원한다.
•
최고 성능의 딥러닝 아키텍처 및 하이퍼파라미터를 찾아준다.
AutoML 과정 표 요약 정리
데이터 전처리 최적화 | 하이퍼 파라미터 튜닝 | 모델 선택 | GUI 지원 여부 | |
Auto-Sklearn | X | O | O | X |
TPOT | X | O | O | X |
Auto-ViML | O | O | O | O |
H2O AutoML | O | O | O | O |
Auto-Keras | X | O | O | X |
MLBox | O | O | O | X |
Hyperopt Sklearn | O | O | O | X |
AutoGluon | O | O | O | O |
Ludwig | O | O | O | O |
•
searching log influencing performence of model in process
•
It is possible to add logging function that confirm learning process in open source
•
H2O, ludwig analysis
•
Searching where to log on the class of open source
•
•
Searching logging part in open source
•
Improving tables by referencing below two papers
•
For process mining (log)
2-9. Ludwig
참고 문헌
•
Ferreira, Luís, et al. "A comparison of AutoML tools for machine learning, deep learning and XGBoost." 2021 International Joint Conference on Neural Networks (IJCNN)
•
•
KEPRI 연구노트
•
Truong, Anh, et al. "Towards automated machine learning: Evaluation and comparison of AutoML approaches and tools." 2019 IEEE 31st international conference on tools with artificial intelligence (ICTAI). IEEE, 2019.
•
